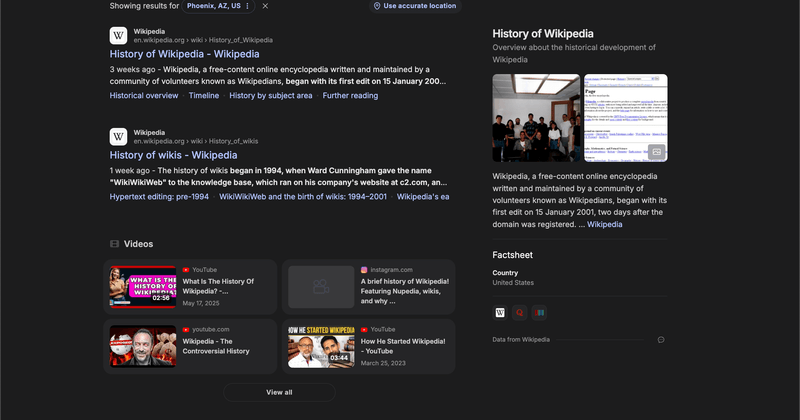
Un client m'a envoyé un lien vers Perplexity en début d'année, avec ce commentaire : « regarde, l'IA parle de nous, mais elle cite notre concurrent. » Il avait raison. Le paragraphe décrivait son produit, reprenait presque mot pour mot un bout de sa page d'accueil… et la source affichée en petit, juste en dessous, pointait vers un annuaire tiers qui l'avait copié-collé. Son site n'existait pas dans la réponse. Voilà où on en est en 2026 : être bien classé dans Google ne garantit plus d'être la source qu'on cite quand une IA répond à la place de l'internaute.
Alors comment préparer son site au référencement dans les réponses IA ? En travaillant trois couches que la plupart des sites WordPress ignorent complètement : l'accès des robots génératifs, la structure sémantique du contenu, et la traçabilité de ce qui est réellement cité. Le reste, c'est du SEO classique qui continue de servir de socle.
Points clés à retenir
- Le référencement dans les réponses IA se joue d'abord sur l'accès : si GPTBot, ClaudeBot ou PerplexityBot sont bloqués dans votre robots.txt, aucune optimisation de contenu ne servira
- Un LLM ne « lit » pas une page comme un humain : il en extrait des passages autonomes, donc chaque bloc de votre page doit tenir debout tout seul
- Le balisage schema.org et une date de mise à jour visible pèsent plus lourd que la densité de mots-clés
- La citation se mesure : sans suivi régulier, vous ne saurez jamais si la manoeuvre fonctionne
- Les exigences diffèrent d'un moteur à l'autre — Perplexity privilégie la fraîcheur, Google AI Overviews s'appuie sur son index existant
Référencement dans les réponses IA : commencez par vérifier qui a le droit d'entrer
C'est le point que personne ne vérifie, et c'est celui qui annule tout le reste. Beaucoup de sites ont activé, entre 2023 et 2025, des règles de blocage des robots IA dans leur fichier robots.txt — parfois par réflexe défensif, parfois via une extension de sécurité qui l'a fait sans prévenir.
Sur un site client, j'ai trouvé une règle User-agent: GPTBot / Disallow: / posée par un plugin de protection anti-scraping. Le site était parfaitement indexé dans Google, il remontait en troisième position sur sa requête principale. Et il était totalement absent des réponses de ChatGPT Search. Le gérant ne comprenait pas pourquoi « l'IA ne le connaissait pas ». On a mis quarante minutes à trouver la cause. Deux semaines après la correction, il apparaissait dans des réponses sur son nom de marque.
Les user-agents à connaître
- GPTBot — crawler d'OpenAI. Le bloquer, c'est disparaître des réponses ChatGPT.
- ClaudeBot — Anthropic.
- PerplexityBot — le plus dépendant de la fraîcheur du contenu.
- Google-Extended — ce n'est pas un crawler de navigation, c'est un réglage qui autorise ou refuse l'usage de votre contenu pour l'entraînement des modèles Gemini. Le bloquer ne vous sort pas de l'index Google classique, mais peut limiter votre présence dans les AI Overviews. Nuance importante, souvent mal comprise.
- Bingbot — indispensable si vous visez Copilot, qui s'appuie sur l'index Bing.
Vérifiez aussi le rendu JavaScript. Un site dont le contenu principal est injecté côté client par un builder lourd peut être invisible pour des crawlers moins patients que Googlebot. Testez avec l'ouverture d'une page en mode « sans JS » : si vous voyez un écran blanc, les IA génératives verront la même chose.
Et le fichier llms.txt, alors ?
Beaucoup en parlent comme d'une norme. Dans les faits, c'est une proposition : un fichier texte à la racine qui résume votre site et pointe vers vos pages importantes, censé aider les modèles à s'y retrouver. Rien ne garantit qu'un moteur donné le lise. Je le pose quand même systématiquement, ça coûte dix minutes et ça ne casse rien. Mais je ne facture pas ça comme une prestation « optimisation IA » — ce serait malhonnête.
Le contenu qu'une IA peut citer : des blocs autonomes, pas de belles pages
Un moteur génératif ne résume pas votre page. Il en découpe des passages, les compare à d'autres sources, et recompose une réponse. Conséquence directe : si votre définition d'un concept est rédigée sur douze lignes d'introduction avant d'arriver au fait, elle sera écartée au profit d'une page concurrente qui l'a posée en une phrase claire.
Ce que je fais maintenant sur chaque page que je retravaille :
- Chaque sous-section commence par une réponse directe, en une ou deux phrases, avant tout développement.
- Les tableaux comparatifs sont conservés tels quels — les modèles les extraient très bien, mieux qu'une liste en prose.
- Les définitions sont formulées à la voix active, sujet-verbe-complément, sans « il convient de noter que ».
- La date de dernière mise à jour est affichée en clair, pas seulement dans le code.
Un détail qui compte plus qu'on ne le croit : nommer l'auteur. Pas « l'équipe éditoriale ». Un nom, une fonction, un lien vers une page qui dit qui est cette personne. Les moteurs qui citent cherchent des sources attribuables — et un contenu sans visage humain est le premier écarté quand plusieurs pages disent la même chose.
Le balisage, sans en faire une religion
Le schema.org de type Article, FAQPage ou HowTo aide les moteurs à comprendre la nature d'un bloc. Ça ne vous fera pas citer à coup sûr, mais ça lève une ambiguïté. J'ai arrêté d'empiler quinze types de balisage sur une seule page : deux ou trois bien posés suffisent, et un balisage mal rempli fait plus de dégâts qu'une page sans balisage.
| Moteur | Ce qu'il privilégie | Levier prioritaire |
|---|---|---|
| Perplexity | Fraîcheur, sources citées explicitement | Pages mises à jour souvent, dates visibles |
| ChatGPT Search | Sources reconnaissables, cohérence | Accès GPTBot + marque identifiable |
| Google AI Overviews | Index Google existant, autorité du domaine | SEO classique + Google-Extended autorisé |
| Copilot | Index Bing | Présence dans Bing Webmaster Tools |
Comment savoir si ça marche vraiment
Il n'existe pas de Search Console des réponses IA. Alors on bricole. Ma méthode, testée sur une dizaine de sites depuis l'an dernier : je liste entre vingt et trente prompts réalistes — pas « meilleur logiciel de facturation », mais « quel logiciel de facturation pour une TPE qui facture à l'étranger ». Je les passe une fois par mois dans les quatre moteurs, je note qui est cité, à quelle position, avec quel lien.
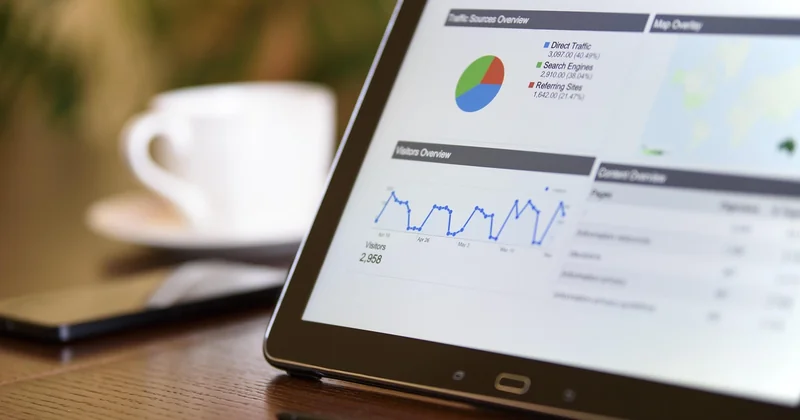
Résultat typique sur un site B2B que j'ai suivi pendant cinq mois : zéro citation au départ, puis trois prompts sur vingt-huit où la marque apparaissait après le déblocage des crawlers et la réécriture de six pages. Pas spectaculaire. Mais mesurable, et reproductible.
Avouons-le, une bonne partie du travail reste artisanale. Des outils de prompt-tracking existent, ils automatisent la collecte, mais je trouve leurs échantillons de prompts trop larges pour dire quoi que ce soit d'utile sur un site précis.
Comment savoir si un site est fait avec IA ?
Question qu'on me pose souvent, et la réponse honnête est : on ne peut pas en être certain. Les détecteurs de texte généré se trompent dans les deux sens, et un contenu IA retravaillé par un humain leur échappe. Ce qu'on peut repérer, ce sont des signaux de négligence : des pages qui répètent la même structure au mot près, des affirmations sans aucune source, des dates de publication identiques sur trente articles, une page auteur vide. Le problème n'est pas que le texte soit généré — c'est qu'il ne contienne rien de vérifiable. Un texte IA bien documenté et un texte humain mal fichu se ressemblent plus que les détecteurs ne veulent l'admettre.
Comment être visible sur Google ?
La base n'a pas changé : un site rapide, indexable, avec des pages qui répondent à une intention précise et des liens entrants de qualité. Ce qui s'ajoute, c'est que Google puise désormais dans ce même index pour composer ses réponses génératives. Autrement dit, un bon SEO classique reste la condition d'entrée. J'ai vu des sites délaisser leur SEO au profit d'« optimisations IA » et perdre leur trafic organique en quelques mois. Erreur de débutant.
Se former et s'outiller sans se faire vendre du vent
Où puis-je trouver une formation Google SEO ?
La formation officielle de Google existe et elle est gratuite : elle se trouve sur Google Skillshop et dans le Google Search Central, qui publie la documentation de référence sur l'exploration et l'indexation. Ce n'est pas là que vous apprendrez à préparer un site aux réponses IA — ce sujet n'y est traité qu'en surface — mais c'est le socle. Pour le reste, méfiez-vous des formations qui promettent de « dominer ChatGPT » : le domaine bouge trop vite pour qu'un module figé reste juste plus de six mois.
Quels outils peuvent être utilisés pour améliorer le SEO d'un site web ?
Ma pile, sans fioritures :
- Search Console — gratuit, irremplaçable pour voir ce que Google explore réellement.
- Bing Webmaster Tools — indispensable si Copilot vous intéresse, et son outil de test d'URL est plus bavard que celui de Google.
- Un outil de suivi de positions classique, pour ne pas perdre la vue d'ensemble organique.
- Un simple tableur pour le suivi des prompts IA. Sérieusement. C'est ce qui marche le mieux à mon sens, et je défendrai ce choix bec et ongles : aucun outil ne connaît vos requêtes métier mieux que vous.
Et un test manuel que je refais tous les mois : chercher le nom de la marque directement dans ChatGPT et dans Perplexity, et regarder ce qui sort. Si la réponse contient une erreur factuelle sur l'entreprise, c'est souvent le signe qu'une source tierce a pris le dessus sur votre propre site.
Ce qui ne se délègue pas
La semaine dernière, un confrère m'a dit qu'il refusait de « faire du GEO » parce que selon lui tout ça n'était qu'une mode. Je comprends l'agacement — le sigle est apparu, les prestations à 3 000 euros aussi, et beaucoup ne contiennent rien de plus qu'un audit robots.txt. Mais la mode n'enlève rien au constat : une part croissante des recherches se termine dans une réponse synthétique, sans clic.
La vraie question n'est pas de savoir si vous allez « optimiser pour les IA ». C'est de savoir si votre contenu mérite d'être repris. Une page qui affirme quelque chose de précis, datée, signée, avec des chiffres qui lui appartiennent, sera citée. Une page qui reformule ce que disent les dix autres n'a aucune raison de l'être, par un humain comme par une machine.
Le jour où vous chercherez votre propre secteur dans Perplexity et que vous verrez votre nom dans la réponse, avec un lien qui pointe enfin vers chez vous et pas vers l'annuaire d'un concurrent — ce jour-là, vous saurez pourquoi vous avez passé une après-midi sur un fichier texte de six lignes.